
La memoria comprimida puede ayudar a Linux cuando la RAM escasea, pero hoy suele gestionarse a través de mecanismos ligados al intercambio de páginas. CRAM, una propuesta presentada por Gregory Price, de Meta, en Linux Plumbers Conference el 5 de octubre, plantea otro camino: que el sistema acceda a los datos comprimidos como memoria normal, por bytes o líneas de caché, y no como si estuvieran en un dispositivo de bloques.
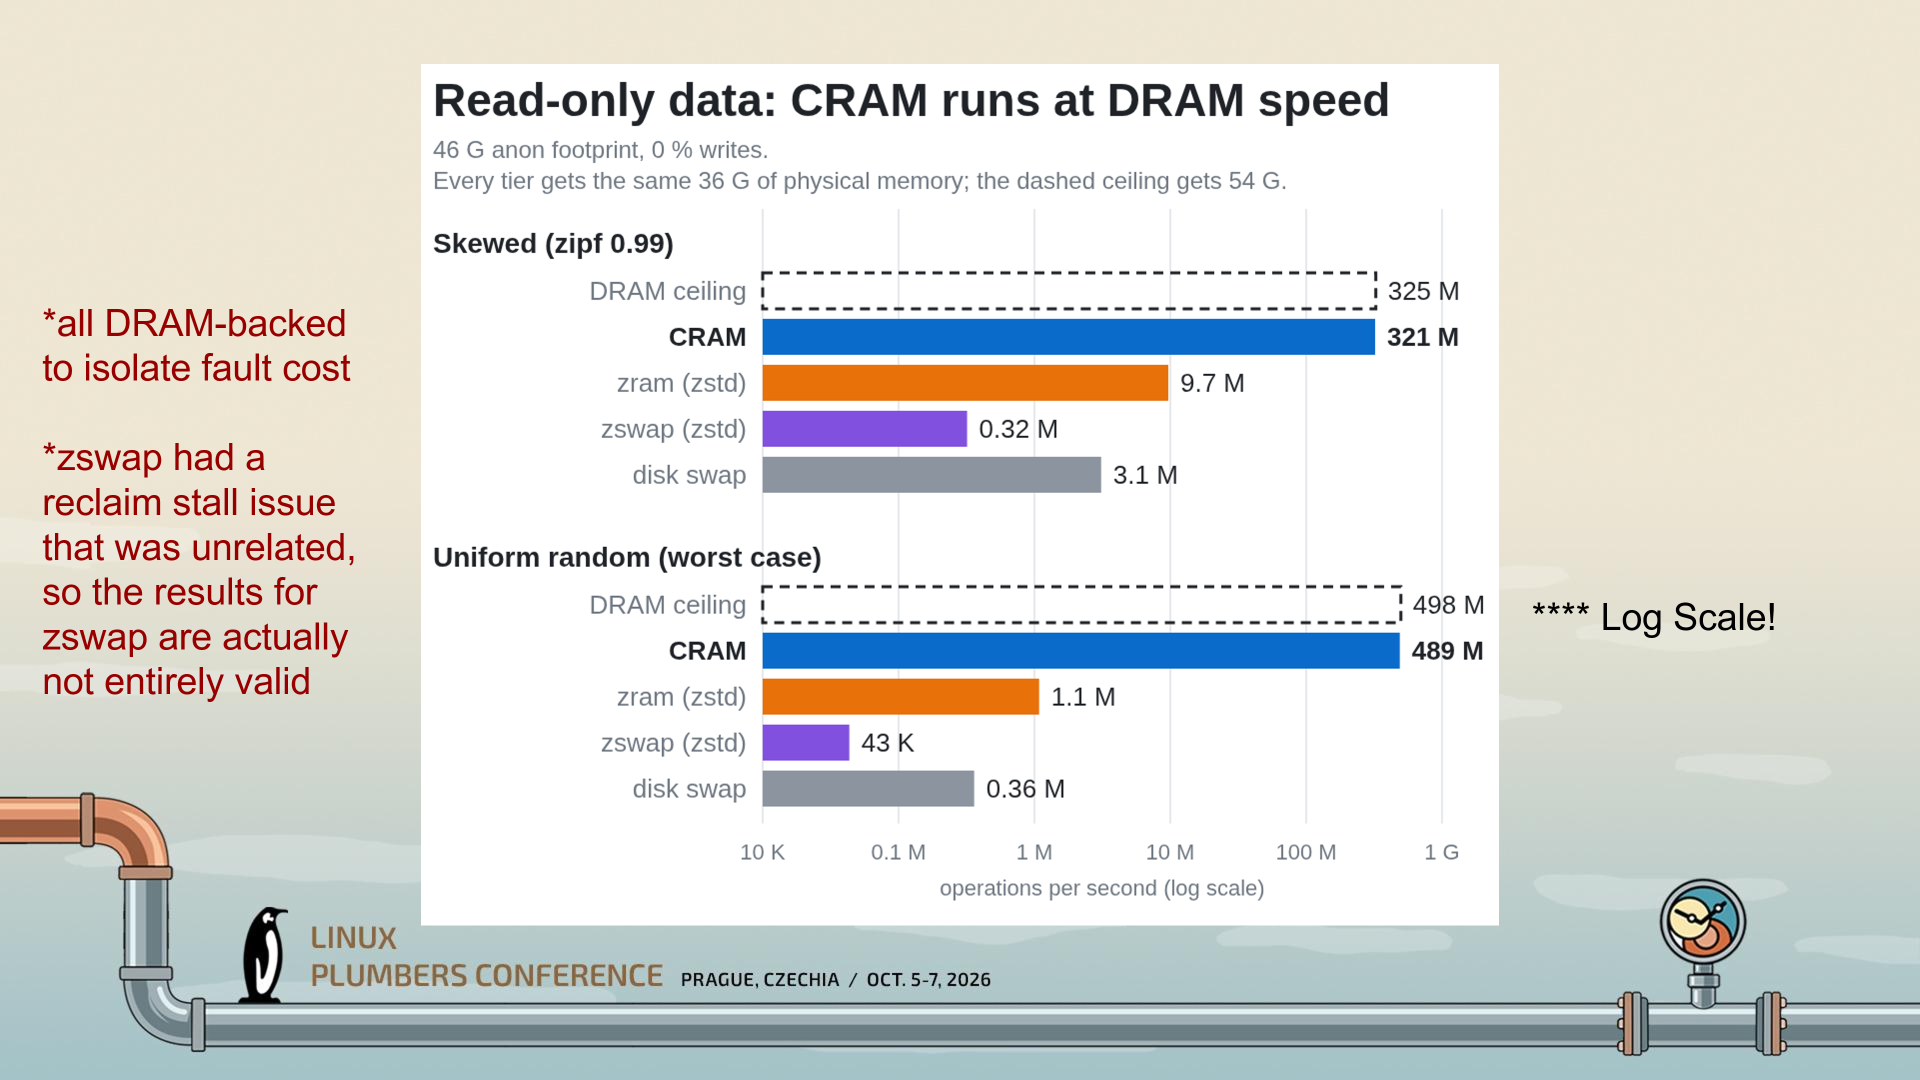
En una prueba de lectura recogida en la presentación, el prototipo se acerca al rendimiento de la DRAM y supera ampliamente a zram. De ahí sale la cifra llamativa de hasta 452 veces más rendimiento. Pero no es una aceleración general de Linux: el ensayo usa datos de solo lectura, mantiene el respaldo en DRAM para aislar el coste de los fallos de página y muestra una gráfica con escala logarítmica. Además, la diapositiva advierte de que los resultados de zswap no son del todo válidos por un problema de reclaim.
CRAM cambia cómo Linux ve la memoria comprimida
La diferencia principal está en la interfaz. zram crea un dispositivo de bloques en RAM: las páginas que se escriben en él se comprimen y se guardan en memoria. zswap, por su parte, funciona como una caché comprimida para páginas que van camino del swap; si su espacio se llena, puede expulsarlas al dispositivo de intercambio de respaldo.
CRAM pretende evitar ese recorrido en los accesos que puede atender directamente. La propuesta aprovecha acceso por byte o línea de caché y presenta esa memoria comprimida al kernel mediante un nodo NUMA privado, una forma de encajarla en los mecanismos habituales de gestión de memoria. Según la descripción oficial de la charla, el objetivo es que pueda seguir mapeada en tablas de páginas y en la caché de páginas sin provocar un fallo de página en cada lectura ni requerir una descompresión por software en ese acceso.
La compresión, además, se delegaría al hardware. Eso es importante: CRAM no describe simplemente una opción que cualquier equipo pueda activar con su procesador actual. Depende de un servicio de memoria comprimida con capacidades específicas y de cambios para que Linux gestione correctamente esa memoria.
Qué dicen realmente las cifras
La presentación muestra que, en su caso más desfavorable de lectura aleatoria, CRAM alcanza 489 millones de operaciones por segundo frente a 1,1 millones de zram. La diferencia ronda las 445 veces; la cifra de hasta 452 veces difundida en la cobertura procede de esa comparación concreta. En otra prueba de lectura, con datos sesgados y compresibles, el resultado es distinto. No conviene convertir ninguno de esos números en una promesa sobre el rendimiento cotidiano de un ordenador.
El propio montaje experimental acota lo que se está midiendo: el respaldo en DRAM sirve para aislar el coste del fallo de página, no para reproducir todas las condiciones de uso de un sistema real. Y aunque la diapositiva incluye una prueba con escrituras, la ventaja cae: en el escenario más desfavorable citado por Tom’s Hardware, con un 20 % de escrituras, CRAM fue 5,4 veces más rápido que zram. Las escrituras requieren pasos adicionales, como recuperar y migrar páginas, porque no se puede modificar sin más un bloque que permanece comprimido.
También hay una cautela específica con zswap: la nota de la gráfica señala un atasco de reclaim ajeno a la comparación y avisa de que sus resultados no son completamente válidos. Esa advertencia hace todavía más importante leer la prueba como una demostración inicial de la arquitectura, no como un duelo definitivo entre soluciones.
Un prototipo con trabajo pendiente
El reto no es solo comprimir rápido, sino saber cuánta memoria física queda realmente disponible cuando su capacidad lógica depende de cuánto se deje comprimir cada página. Los datos con muchos ceros se reducen mucho; los ya comprimidos, poco o nada. La charla plantea cuestiones de capacidad y asignación, y contempla frenar el uso de CRAM durante ciertas operaciones para evitar que una asignación fallida desencadene problemas en cadena.
Gregory Price presentó un prototipo identificado como mm/cram.c y afirmó que se había probado con TAOBench, FIO y varios sistemas de archivos integrados en el kernel. Eso acredita trabajo experimental, no su incorporación al kernel principal ni su disponibilidad en distribuciones o equipos de consumo. La propuesta aún tiene que resolver sus límites de capacidad y comportamiento ante escrituras, además de depender del hardware de compresión previsto.
Por ahora, CRAM es una línea de desarrollo interesante para aprovechar mejor la memoria, sobre todo en entornos donde importa reducir el coste de las lecturas comprimidas. El dato de 452 veces resume un escenario muy concreto; no significa que un PC Linux vaya a multiplicar por esa cifra su velocidad ni que zram y zswap vayan a desaparecer.
