
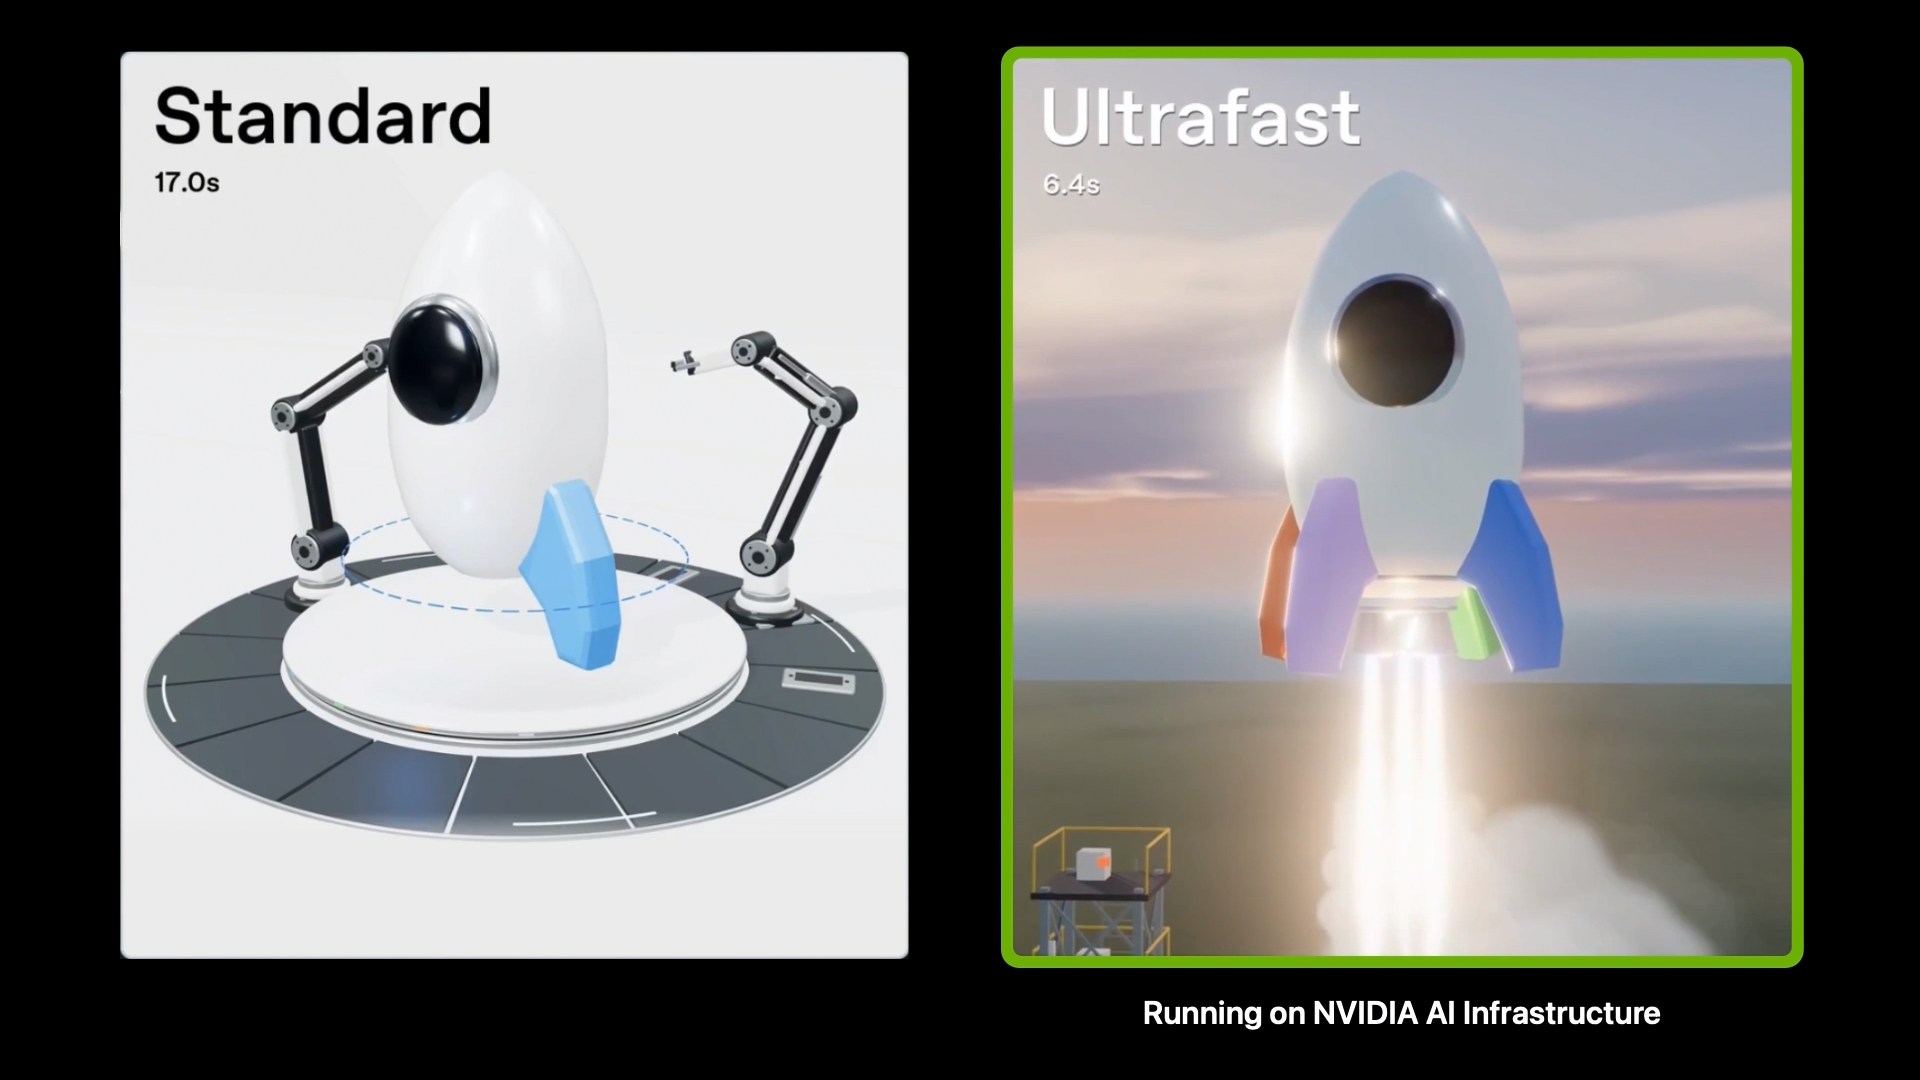
NVIDIA afirma que GPT-6 Astra Ultrafast, el modo de respuesta de mayor velocidad de OpenAI, funciona sobre GPU de arquitectura Blackwell y puede generar tokens hasta ocho veces más rápido que Astra Standard. La mejora está pensada especialmente para tareas interactivas: por ejemplo, cuando un agente de programación alterna entre escribir código, ejecutar herramientas y revisar resultados.
El anuncio se publicó el 1 de octubre de 2026. La cifra de ocho veces procede de NVIDIA y de la documentación de OpenAI, pero se refiere a la velocidad de generación, no a que cualquier consulta o tarea completa termine ocho veces antes. El tiempo total también depende de la petición, las llamadas a herramientas y la conexión utilizada.
Una opción de baja latencia para los ciclos de los agentes
En un flujo de programación asistido por IA, el modelo puede proponer cambios, invocar una herramienta para ejecutar pruebas y después interpretar la salida. La espera se repite en cada turno; reducir el tiempo de generación puede hacer más ágiles esos ciclos de edición, prueba y depuración. NVIDIA sostiene que Ultrafast está orientado precisamente a esas interacciones sensibles a la latencia, además de aplicaciones que requieren respuestas rápidas.
La compañía atribuye el rendimiento a las GPU Blackwell y a las optimizaciones de inferencia que OpenAI aplica a sus modelos para aprovechar la arquitectura. Según la publicación de NVIDIA, OpenAI también ha utilizado modelos internos para ajustar el software de inferencia. El anuncio no aporta una prueba independiente ni una comparación detallada de cargas de trabajo que permita trasladar el máximo anunciado a todos los casos de uso.
Disponibilidad en la API, Work y Codex
En la API, OpenAI ofrece Ultrafast como una modalidad de servicio para GPT-6 Astra. La documentación técnica indica que está disponible para todos los usuarios de la API con límites de uso iniciales bajos y señala que la velocidad debe justificar el mayor coste. Para aplicaciones con muchas llamadas consecutivas a herramientas, OpenAI recomienda conexiones WebSocket persistentes: las conexiones tradicionales pueden añadir latencia de red y reducir parte de la ventaja.
En ChatGPT Work y Codex, el acceso no es general. La ayuda de OpenAI indica que Ultrafast está disponible en el plan Pro de 500 dólares y en espacios de trabajo Enterprise y Edu elegibles, sujeto a permisos y créditos. No se incluye en el lanzamiento para Plus, Pro de 100 o 200 dólares ni Business. Por eso, la disponibilidad anunciada debe entenderse como condicionada por el plan o la cuenta, no como una función accesible para cualquier usuario de ChatGPT.
Más velocidad no significa ocho veces menos tiempo en cada tarea
La promesa puede tener más impacto en procesos que requieren respuestas frecuentes y encadenadas que en una consulta aislada. Si el agente pasa parte del tiempo ejecutando código, esperando servicios externos o transfiriendo datos, acelerar la generación de tokens no elimina esos otros cuellos de botella. El beneficio real dependerá también de cuánto texto genere el modelo y de cómo esté construida la aplicación.
Para desarrolladores, Ultrafast plantea una elección entre latencia y coste: puede ser útil cuando la rapidez de respuesta mejora la experiencia o reduce pausas en un agente, mientras que el modo estándar puede bastar para tareas no interactivas. OpenAI no presenta el cambio como una nueva capacidad del modelo, sino como una modalidad más rápida para servir GPT-6 Astra. La comparación práctica, por tanto, debería medir el tiempo total y el gasto en el flujo de trabajo concreto, no solo la velocidad máxima de generación.
