
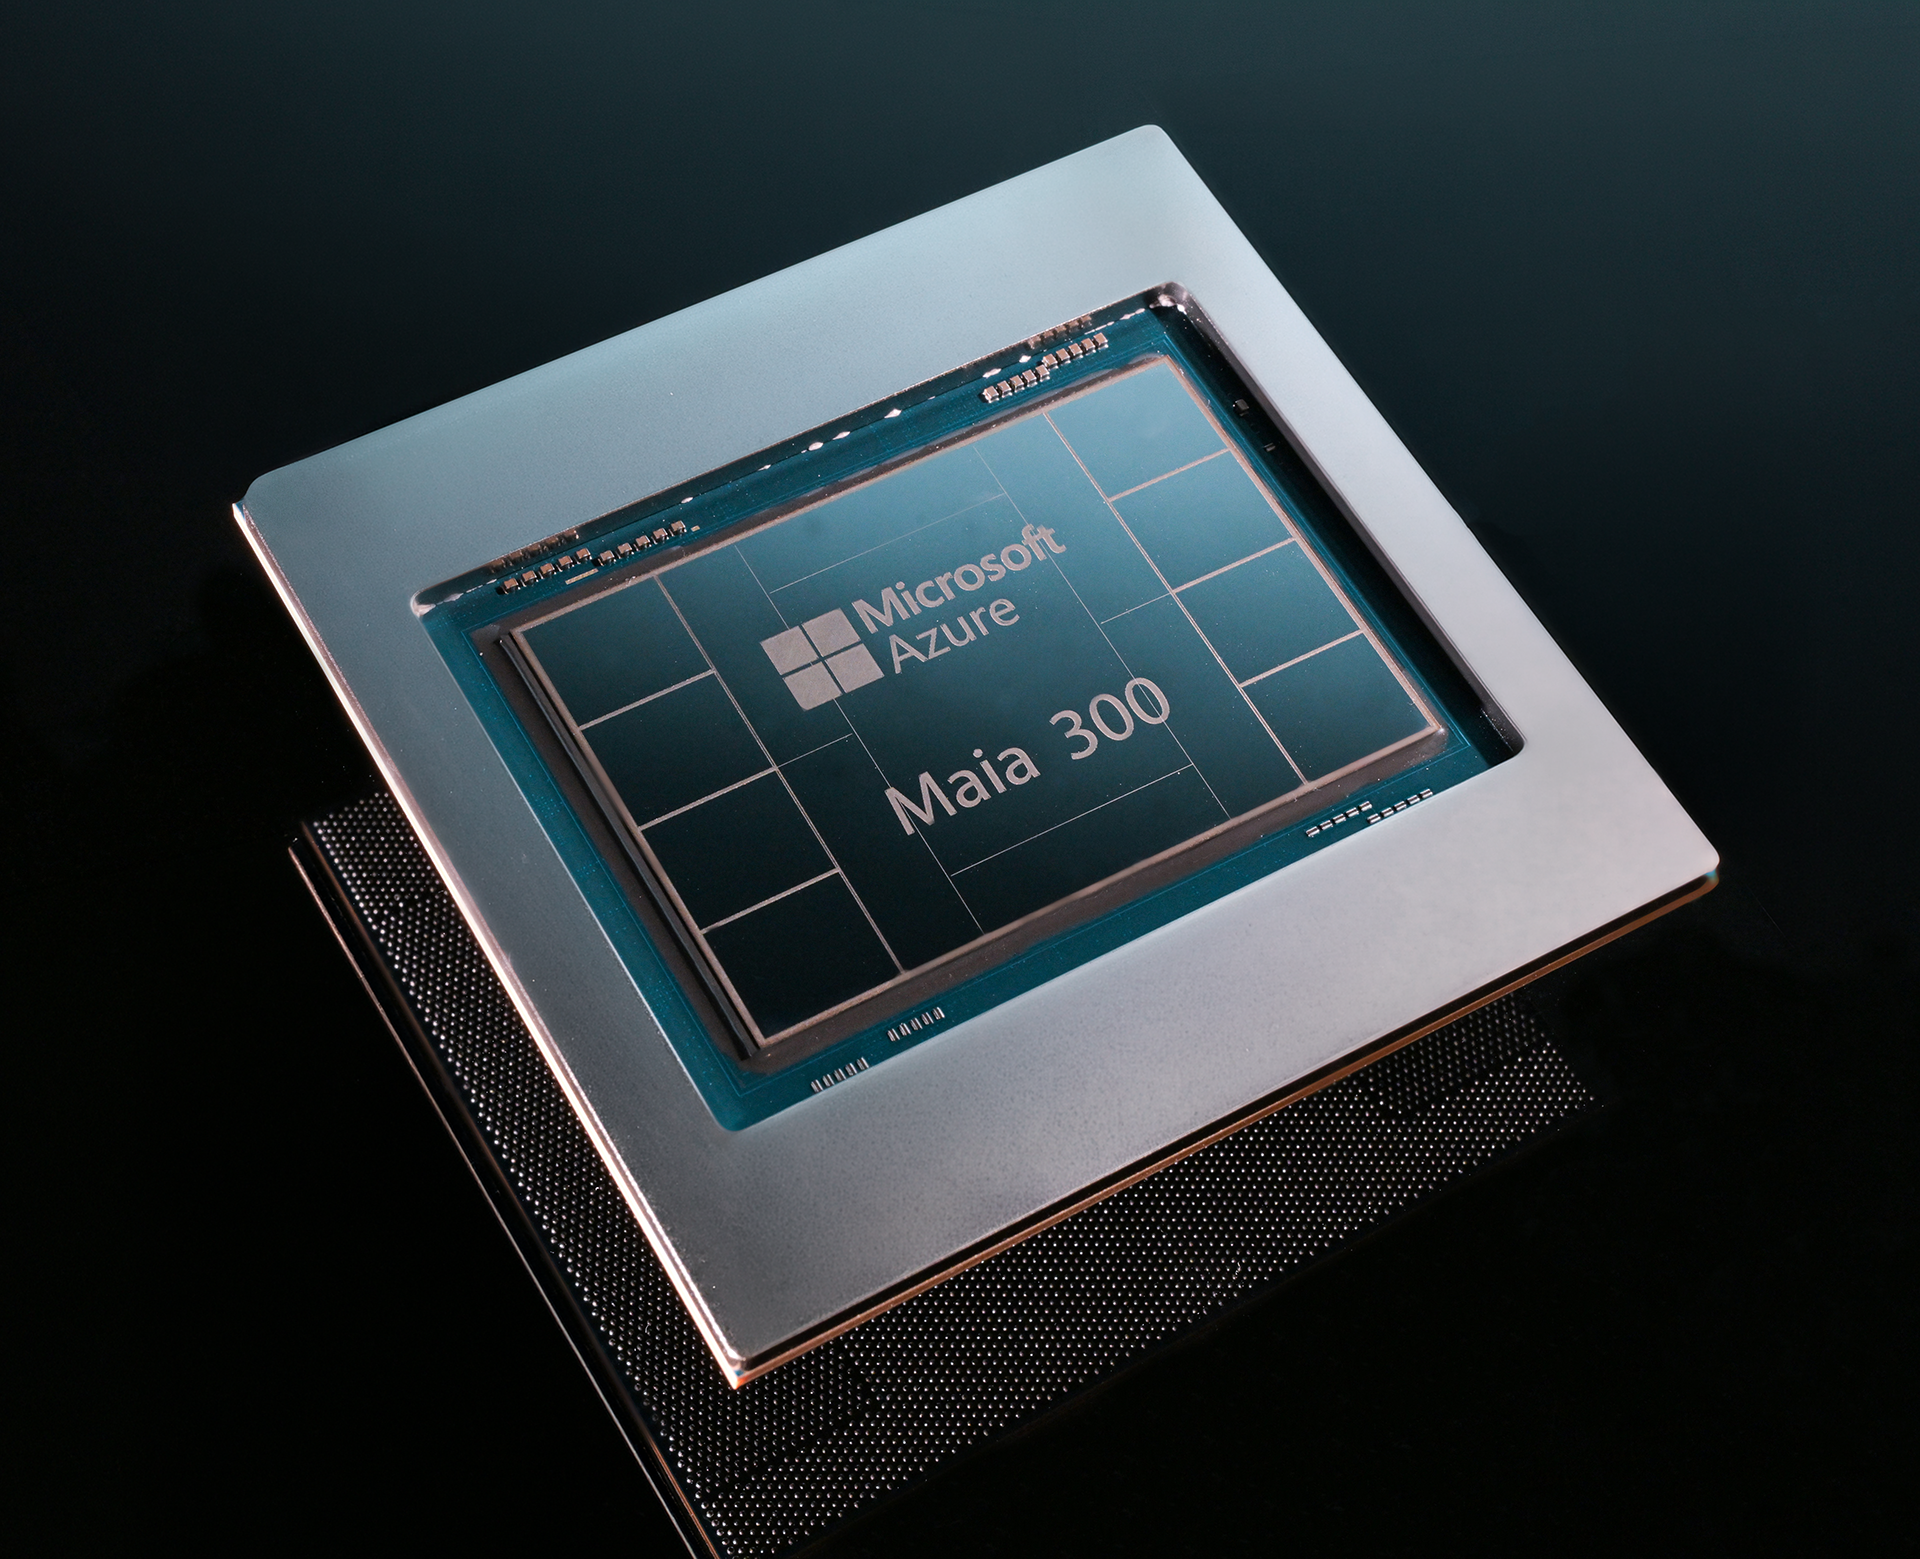
Microsoft quiere que el corazón de su IA lleve cada vez más silicio propio. La compañía ha presentado hoy, 12 de octubre de 2026, Azure Maia 300, un sistema de aceleradores cuyo despliegue en producción empezará en 2027. Su promesa más llamativa: un 40 % más de tokens por megavatio frente a los sistemas basados en GPU que utiliza como referencia.
La apuesta va más allá de fabricar un chip potente. Cada respuesta de un asistente consume recursos; cuando millones de personas utilizan esos servicios, la electricidad, la memoria y la capacidad del centro de datos se convierten en parte del producto. Microsoft pretende optimizar esa cadena desde el procesador hasta las aplicaciones.
Copilot ya utiliza Maia 200; el siguiente salto llegará en 2027
El anuncio de Scott Guthrie confirma que Maia 200 ya atiende cargas de producción, incluido Microsoft Copilot. GitHub Copilot y Microsoft Foundry se incorporarán antes de terminar este año. Desde 2027, Microsoft quiere ampliar la familia Maia a despliegues de varios gigavatios y convertirla en su principal sistema de inferencia.
La inferencia es el trabajo de ejecutar un modelo para responder o completar tareas. Controlar su infraestructura permite ajustar el hardware a lo que hacen los servicios de la compañía. Eso puede mejorar la capacidad disponible, aunque el anuncio no garantiza respuestas más rápidas ni suscripciones más baratas para el usuario.
La promesa del 40 % tiene condiciones
Microsoft espera esa mejora de tokens por megavatio con Maia 300. También anuncia hasta siete veces el volumen de tokens por rack frente a Maia 200, en una configuración completa de 96 aceleradores.
Son cifras del fabricante. El comunicado habla de sistemas GPU líderes, pero no identifica en esa comparación una configuración concreta ni aporta una evaluación independiente. Además, el rack de Maia 300 duplica el número de aceleradores: el salto agregado no debe leerse como siete veces más velocidad en cada chip o en cualquier consulta.
288 GB de memoria para alimentar cada acelerador
La documentación técnica oficial describe ocho pilas de memoria HBM4 por acelerador, con 288 GB de capacidad y 18 TB/s de ancho de banda. Los chiplets de cálculo utilizarán el proceso N2P de TSMC.
El diseño prioriza que los datos recorran menos distancia y permanezcan cerca de donde se procesan. Esa decisión resulta especialmente relevante en modelos grandes y tareas con mucho contexto: disponer de más potencia de cálculo sirve de poco si la memoria no consigue alimentarla.
| Escala | Capacidad HBM | Referencia de potencia |
|---|---|---|
| Un acelerador Maia 300 | 288 GB | TDP de 950 W |
| Rack de 96 aceleradores | 27,6 TB | Envolvente de 167 kW |
Las dos magnitudes de potencia describen niveles distintos del sistema. El rack incluye más componentes que los aceleradores y combina refrigeración líquida y por aire.
El reto está en los agentes que trabajan durante más tiempo
Microsoft orienta Maia 300 a razonamiento con contextos largos y agentes que encadenan acciones. Son herramientas que pueden mantener varias etapas de trabajo antes de devolver un resultado, con exigencias diferentes a una respuesta breve.
Esa infraestructura complementa la otra cara del problema: los límites de ejecución para agentes de IA que Microsoft ya ha llevado a Windows. Una pieza busca servir más trabajo; la otra delimita qué pueden hacer esas herramientas.
Maia 300 tendrá que demostrar su ventaja cuando empiece el despliegue. El anuncio sí deja clara la dirección: Microsoft quiere decidir cómo se fabrica y cómo se ejecuta una parte creciente de la IA que vende.
Fuentes
- Microsoft: anuncio de Maia 300 y expansión de Azure Maia, 12 de octubre de 2026.
- Microsoft Azure: arquitectura de Maia 300, 12 de octubre de 2026.
- Microsoft: material oficial e imágenes del prototipo.

<span class="dsq-postid" data-dsqidentifier="9330 https://bytecora.net/?p=9330">1 comentario
Pingback: Intel D270: hasta 480 GB de memoria para inferencia de IA