
AMD ha publicado nuevas pruebas de inteligencia artificial generativa local con el Ryzen AI Max+ PRO 495, su procesador Gorgon Halo con hasta 192 GB de memoria unificada. La compañía destaca que puede ejecutar modelos grandes sin enviarlos a la nube y ha compartido cifras de hasta 20 tokens por segundo con GLM 5.3 Flash y 42 con Qwen 3.8 Flash Next. Son, eso sí, resultados propios y dependientes de la configuración: no equivalen a una comparativa independiente ni dicen nada sobre el rendimiento en juegos.
Las pruebas llegan mientras se acerca la llegada de los PC RTX Spark de Nvidia, también dirigidos a la IA local y anunciados con hasta 128 GB de memoria unificada. AMD no los enfrenta directamente en sus gráficas: compara su chip con el Core Ultra X9 388H de Intel y presenta por separado las cifras de los modelos de lenguaje. Tom’s Hardware detalla las pruebas, mientras que Nvidia sitúa la llegada de RTX Spark en octubre.
Más memoria permite cargar modelos mayores; no los acelera por sí sola
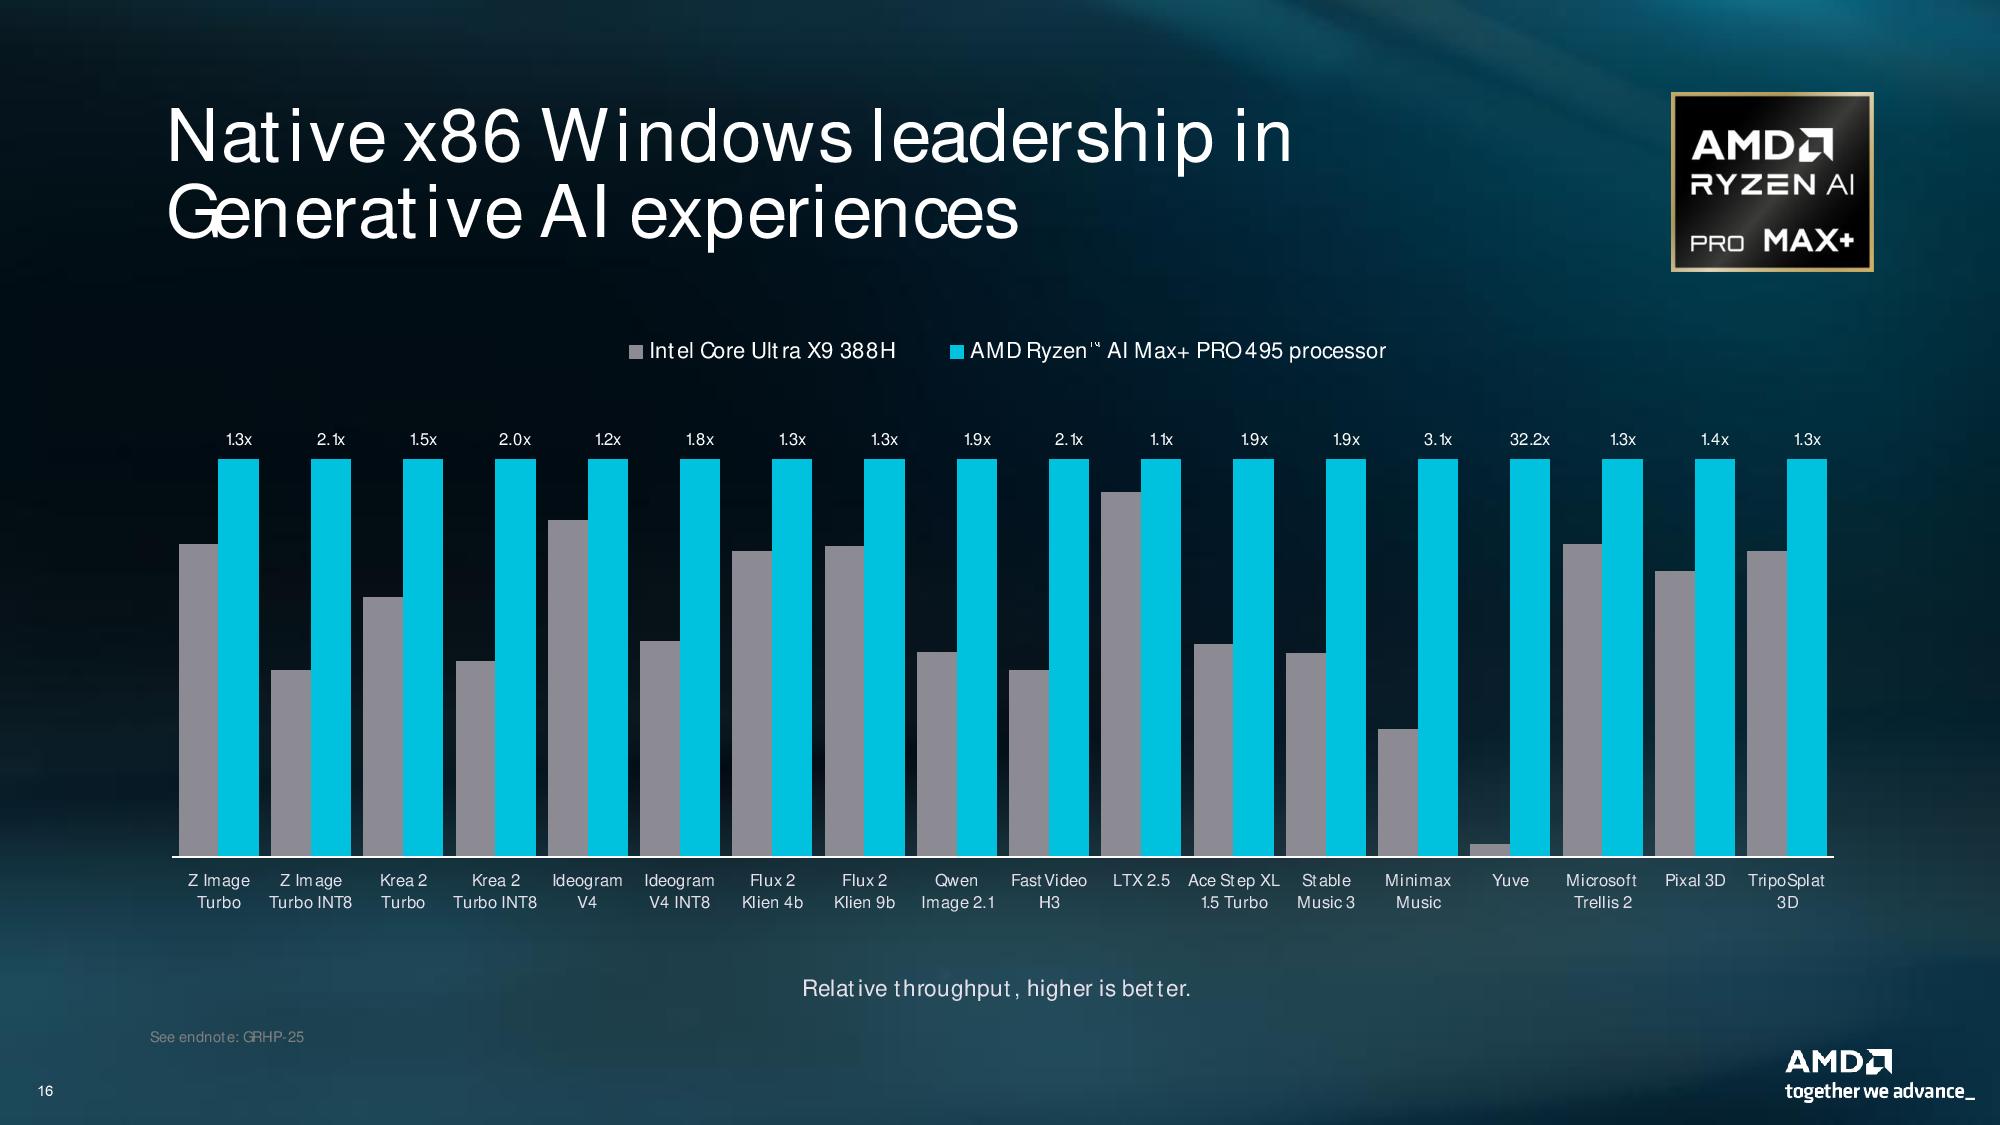
En ComfyUI, AMD compara el Ryzen AI Max+ PRO 495 con 192 GB de memoria frente a un equipo con Intel Core Ultra X9 388H y 64 GB. En la diapositiva, la compañía muestra una ventaja relativa que va de 1,1 a 32,2 veces según la tarea. La cifra más alta corresponde a Yuve, un resultado atípico que la fuente original señala como difícil de contextualizar; además, las dos configuraciones no tienen la misma cantidad de memoria. Por eso, la gráfica sirve como referencia de las pruebas de AMD, no como una clasificación general de procesadores.
La apuesta de Gorgon Halo está especialmente en la capacidad. Su memoria unificada puede ser utilizada por la CPU y la GPU, lo que deja más espacio para cargar modelos grandes en el propio equipo. AMD especifica hasta 192 GB para el 495, frente al máximo de 128 GB anunciado para RTX Spark. Pero poder cargar un modelo no significa que vaya a responder deprisa: influyen también la cuantización —una técnica que reduce el tamaño del modelo—, el software, la longitud del contexto y el hardware que procesa cada operación.
Las cifras de tokens por segundo son máximos de AMD
En sus pruebas, AMD atribuye al 495 hasta 20 tokens por segundo con GLM 5.3 Flash, un modelo de 320.000 millones de parámetros, usando el formato de cuantización UD-IQ4_XS de Unsloth. La empresa también comunica hasta 42 tokens por segundo con Qwen 3.8 Flash Next, mediante cuantización dinámica de 4 bits y predicción de varios tokens. En estos modelos de tipo mixture of experts no todos los parámetros se activan para cada token, otra razón por la que el tamaño total no basta para anticipar la velocidad.
El “hasta” importa: el rendimiento puede caer al aumentar el contexto de la conversación y cambiar según la implementación. Tampoco se deben comparar estas cifras sin más con resultados de otro equipo que ejecute un modelo distinto. La prueba describe una configuración concreta, no una garantía de velocidad para cualquier modelo o tarea.
AMD afirma además que ha enviado más de medio millón de “Agentic PCs”, la categoría comercial con la que agrupa equipos pensados para ejecutar agentes de IA localmente. La cifra es una declaración de la compañía y no viene acompañada en la información publicada de un desglose de modelos o ventas. El dato ayuda a entender que AMD quiere presentar Gorgon Halo como parte de una gama ya desplegada, aunque los benchmarks compartidos se centran en hardware de gama alta y no representan por sí solos a todos esos equipos.
